
 Société13 novembre 2026
Que deviennent les données confiées à une IA ?
Conservation, entraînement, relecture et publicité, de ChatGPT à DeepSeek




Un téléphone ouvert sur une conversation avec ChatGPT, en mai 2023. Photo Jernej Furman, CC BY 2.0, via Wikimedia Commons.
Une conversation envoyée à un assistant reste sur les serveurs de son éditeur de 72 heures à plusieurs années, selon l'assistant et les réglages. Dans les versions grand public, elle sert par défaut à entraîner les modèles chez 6 des 7 assistants relevés, et peut être lue par des personnes ou orienter la publicité ; la plupart des offres d'entreprise excluent l'entraînement. La justice, la relecture de sécurité et ce qu'un modèle a déjà appris échappent en grande partie aux réglages.
Sommaire
En mai 2025, dans le procès que lui intente le New York Times, OpenAI a reçu l'ordre de conserver les conversations de ChatGPT, y compris celles que leurs auteurs avaient effacées ; selon OpenAI, les offres Enterprise et Edu n'étaient pas concernées. L'obligation générale a pris fin le 26 septembre suivant, mais les conversations déjà conservées et celles des comptes désignés par le journal restent accessibles. Fin 2025, la juge Ona Wang a ordonné de remettre aux avocats des journaux 20 millions de conversations, dépersonnalisées par OpenAI.
Le sort d'une conversation dépend ainsi de l'offre autant que des réglages. Ce relevé compare 7 assistants, d'après les règles en vigueur en novembre 2026.
Après l'envoi, une conversation peut suivre 5 chemins
Un message envoyé à un assistant, avec le document ou l'image qui l'accompagne, part sur les serveurs de son éditeur et entre dans un historique que l'utilisateur voit et peut effacer. De là, il peut servir à entraîner les modèles suivants, être lu par une personne, orienter une publicité, devenir public par un lien de partage, ou être remis à un tribunal ou à la police. Certains de ces chemins se ferment par un réglage, d'autres par un contrat, d'autres par aucun des 2.
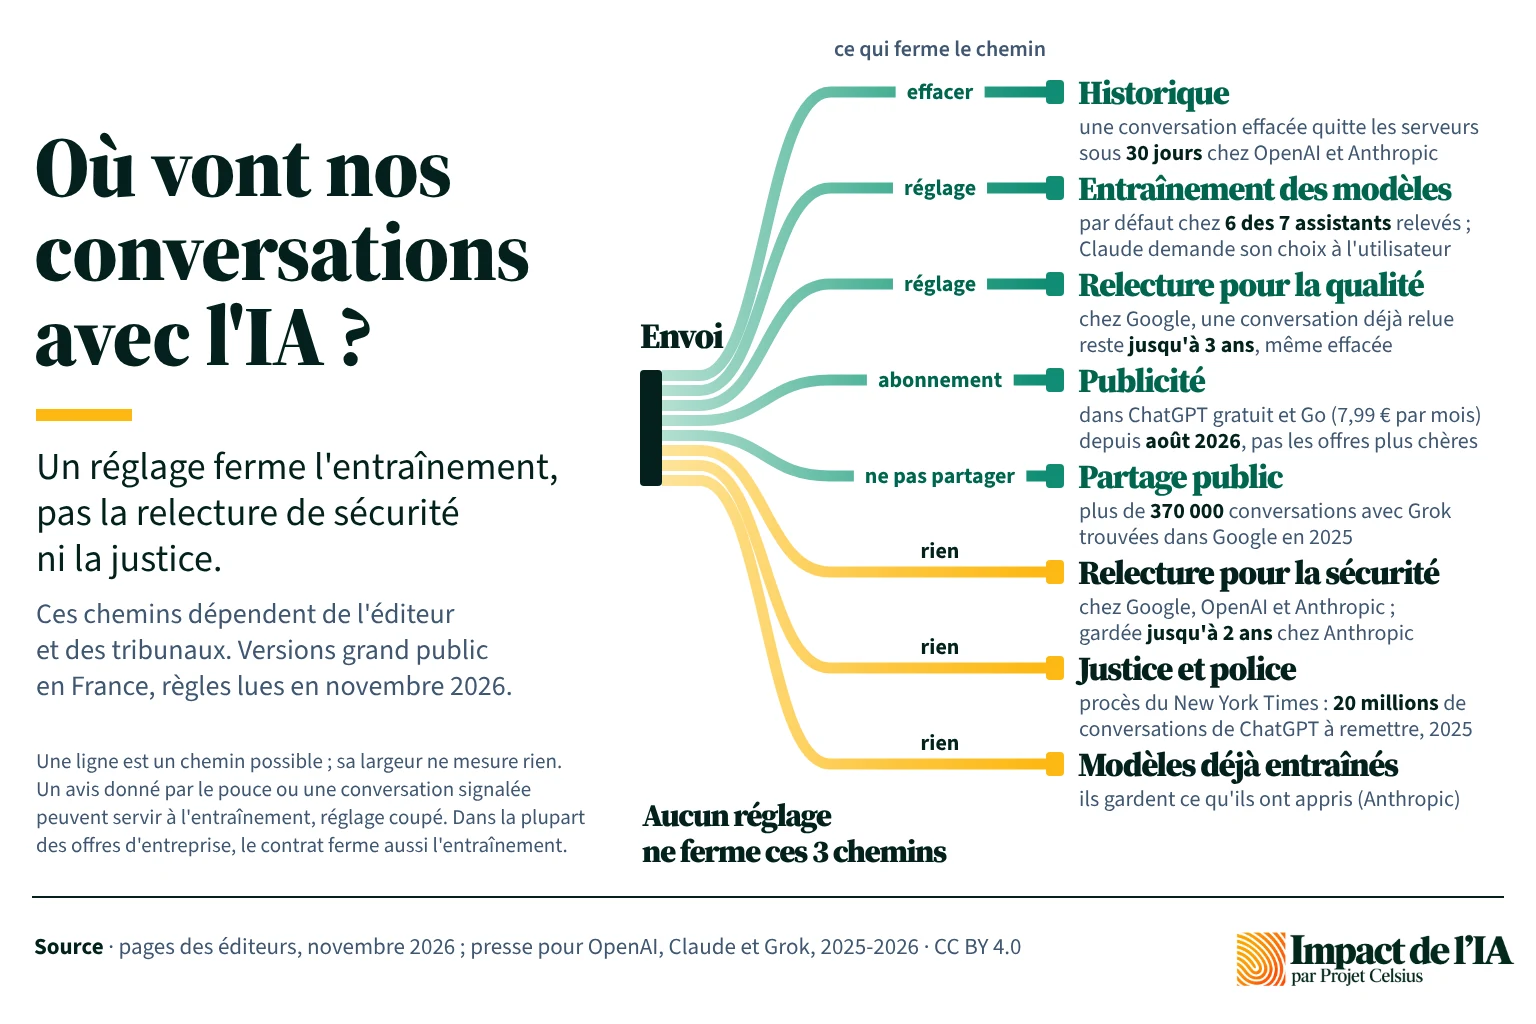
Les fichiers suivent le même trajet : chez Google, réglage actif, un échantillon des fichiers et des photos envoyés depuis le 2 septembre 2025 sert à améliorer les services.
Dans les versions grand public, l'entraînement est la règle par défaut
Chez 6 des 7 assistants relevés, une conversation sert à entraîner les modèles tant que l'utilisateur ne s'y oppose pas. Chez Google, l'entraînement suit le réglage qui garde l'historique, « Conserver l'activité », actif par défaut à partir de 18 ans. Anthropic, l'éditeur de Claude, demande son choix à chaque utilisateur depuis août 2025. Un abonnement personnel ne change pas la règle : les offres Plus et Pro de ChatGPT, Pro et Max de Claude suivent celle de la version gratuite, comme tous les comptes individuels de Vibe (ex-Le Chat).
| Assistant | Entraînement sur les conversations | Conservation |
|---|---|---|
| ChatGPT (OpenAI) | Par défaut ; réglage « Améliorer le modèle pour tout le monde » | Effacée des serveurs sous 30 jours après suppression ; conversation temporaire gardée 30 jours |
| Gemini (Google) | Par défaut dès 18 ans (« Conserver l'activité ») ; jamais en conversation temporaire | 18 mois par défaut, de 3 mois à sans limite ; 72 heures sans historique ; jusqu'à 3 ans si relue |
| Claude (Anthropic) | Choix demandé depuis 2025, interrupteur activé d'avance selon la presse | Effacée des serveurs sous 30 jours après suppression ; jusqu'à 5 ans avec accord pour l'entraînement |
| Copilot (Microsoft) | Par défaut dans l'ancienne application, la France n'étant pas parmi les pays exclus ; non précisé pour la nouvelle | 18 mois dans l'ancienne application ; non précisée pour la nouvelle |
| Meta AI (Meta) | Oui ; dans l'Union, formulaire d'opposition | Non précisée dans les pages lues |
| Vibe (Mistral AI) | Par défaut ; réglage dans les paramètres ; un avis (pouce et commentaire) l'autorise toujours | Non précisée dans les pages lues |
| DeepSeek | Oui ; réglage « Improve the model for everyone » | Tant que le compte existe, en Chine |
Comptes personnels d'adultes. Règles publiées par les éditeurs, lues en novembre 2026 ; celles d'OpenAI d'après la presse de 2025 et 2026 ; celle de Copilot publiée pour l'ancienne application.
Le chemin de chaque réglage est détaillé dans notre classement éthique des assistants et dans une page de la CNIL. Un avis donné par le pouce fait entrer la conversation dans les données de l'éditeur : Anthropic garde ces avis 5 ans, Mistral AI se sert sur toutes ses offres de ceux qui portent un commentaire, et le réglage d'entraînement de ChatGPT ne les couvre pas. Couper l'entraînement n'a pas partout la même portée : Microsoft en exclut les conversations à venir, sans rien dire des précédentes ; Anthropic cesse aussi d'utiliser les conversations déjà gardées, sauf dans les modèles déjà entraînés.
Sur WhatsApp, Meta AI ne voit pas les messages personnels, chiffrés de bout en bout. Meta reçoit ce qu'on écrit à Meta AI, dans un groupe n'importe quel participant peut l'appeler, et dans l'Union un message ainsi partagé peut servir à entraîner ses modèles.
Une conversation reste de 72 heures à plusieurs années sur les serveurs
Chez Google, la même conversation reste 72 heures ou 18 mois selon un seul réglage.
Conversation temporaire, ou réglage « Conserver l'activité » désactivé.
Suppression automatique réglable à 3 mois, 36 mois ou sans limite.
Effacer une conversation la retire tout de suite de l'historique ; chez OpenAI comme chez Anthropic, elle quitte ensuite les serveurs sous 30 jours. Chez Anthropic, une conversation effacée ne sert plus aux entraînements suivants, mais reste dans les modèles déjà entraînés. Ce délai ne touche pas toutes les copies : une conversation relue chez Google reste jusqu'à 3 ans, même effacée.
Garder une année de conversations sur les serveurs demande moins de 10 gCO2e, d'après notre calcul sur les gestes qui réduisent l'impact de l'IA.
Une partie des conversations est lue par des personnes
Les éditeurs font lire des conversations pour noter la qualité des réponses et pour repérer les abus. Chez Google, un échantillon des conversations avec Gemini est relu, y compris par des prestataires, après avoir été détaché du compte, puis gardé jusqu'à 3 ans, même si l'utilisateur efface son activité. Couper « Conserver l'activité » arrête cette relecture pour les conversations suivantes, sauf celle qui sert à la sécurité, et le contrat Google Workspace l'exclut. La page de confidentialité de Gemini demande de ne pas saisir d'informations confidentielles qu'on ne voudrait pas montrer à un relecteur.
En août 2025, OpenAI expliquait transmettre à une petite équipe les conversations où un utilisateur projette de nuire à autrui ; si elle juge la menace imminente, l'entreprise peut prévenir la police, ce qu'elle disait ne pas faire pour les cas d'automutilation. Anthropic garde 2 ans les conversations signalées par ses outils de sécurité, et 7 ans les scores de classification. Chez OpenAI et Anthropic, les réglages d'entraînement ne couvrent pas ces relectures de sécurité.
Depuis fin 2025, la publicité s'appuie sur les conversations
Meta se sert depuis le 16 décembre 2025 des échanges avec Meta AI pour choisir les publicités et les contenus de ses applications. Les échanges sur des sujets sensibles, comme la santé ou les opinions politiques, ne servent pas à la publicité, et l'utilisateur ne peut pas s'opposer au reste. L'Union européenne, le Royaume-Uni et la Corée du Sud en étaient exclus au lancement.
ChatGPT affiche des publicités en France depuis le 24 août 2026, dans ses versions gratuite et Go ; les abonnements plus chers en sont exempts. Dans l'Espace économique européen, elles ne sont pas personnalisées pour l'instant : elles sont choisies d'après le sujet de la conversation en cours, et OpenAI dit ne transmettre aux annonceurs que des statistiques. La nouvelle application Copilot choisit ses publicités génériques d'après la conversation en cours, et peut les personnaliser à partir de l'historique tant que le réglage reste actif. Google écrit que les conversations avec Gemini ne servent pas à la publicité.
Un lien de partage a déjà rendu publiques des centaines de milliers de conversations
Fin juillet 2025, des journalistes ont trouvé des milliers de conversations de ChatGPT dans les résultats de Google, rendues « découvrables » par une case de la fenêtre de partage. OpenAI a retiré cette case dans la foulée. En août, Forbes comptait plus de 370 000 conversations avec Grok indexées par Google, publiées par son bouton de partage sans avertissement ; certaines contenaient des questions de santé, des noms, un mot de passe.
Dans les offres d'entreprise, le contrat fixe l'entraînement et la conservation
Dans la plupart des offres pour les organisations, la règle s'inverse : les conversations sont exclues de l'entraînement par défaut. Chez Mistral AI, seule l'offre Enterprise l'est ; dans l'offre Team, c'est à l'administrateur de couper l'entraînement pour toute l'organisation. Microsoft écrit agir comme sous-traitant au sens du RGPD et n'utiliser les données que sur instruction du client ; Google et Microsoft laissent l'organisation fixer la durée de conservation.
| Offre pour les organisations | Règle de l'éditeur |
|---|---|
| ChatGPT Business (ex-Team) et Enterprise | Conversations exclues de l'entraînement par défaut |
| Claude for Work | Entrées et réponses exclues de l'entraînement par défaut, sauf avis donné par le pouce |
| Gemini dans Google Workspace | Ni relecture humaine ni entraînement hors de l'organisation sans sa permission ; conservation de 3 à 36 mois, 18 mois par défaut |
| Microsoft 365 Copilot et Copilot Chat | Pas d'entraînement des modèles de fondation ; règles de conservation de l'organisation ; Microsoft agit comme sous-traitant |
| Vibe Enterprise et Team | Enterprise exclu par défaut ; dans Team, l'administrateur coupe l'entraînement pour toute l'organisation |
Règles publiées par les éditeurs, lues en novembre 2026 ; celle d'OpenAI d'après la presse.
Chez Microsoft, les recherches envoyées à Bing sortent de l'accord de traitement des données ; les modèles Claude y restent, mais peuvent être traités hors de l'Union. Le contrat ne couvre enfin que les comptes de l'organisation : le guide d'usage de l'IA publié par l'État en juin 2026 demande à ses agents d'éviter le compte personnel pour un usage professionnel.
La justice, la sécurité et les modèles déjà entraînés échappent aux réglages
4 chemins échappent aux réglages de l'utilisateur, et en partie au contrat.
- La justice. Dans le procès du New York Times, les offres Enterprise et Edu de ChatGPT n'étaient pas visées ; les autres l'étaient, conversations effacées comprises. Sam Altman, le patron d'OpenAI, reconnaissait en juillet 2025 qu'une conversation avec ChatGPT n'a pas la protection juridique d'un échange avec un médecin ou un avocat.
- Les autorités. Les politiques d'Anthropic et de DeepSeek prévoient de leur communiquer des données pour se conformer à la loi ou répondre à une demande des pouvoirs publics.
- La sécurité. Une conversation signalée par les outils d'Anthropic reste jusqu'à 2 ans et peut servir à l'entraînement même si l'utilisateur l'a refusé ; chez Google, la relecture de sécurité reste possible réglage coupé.
- Les modèles déjà entraînés. Anthropic l'écrit : les données restent dans les modèles déjà entraînés, même quand l'utilisateur coupe le réglage. Selon le comité européen de la protection des données, un modèle n'est anonyme que s'il est très peu probable d'y identifier les personnes ou d'en extraire leurs données par des requêtes, ce qui se juge cas par cas.
Le pays de l'éditeur compte aussi : DeepSeek stocke les données en Chine, Anthropic, par exemple, transfère celles des Européens aux États-Unis, et le guide de l'État rappelle qu'un service hébergé dans l'Union peut rester soumis au Cloud Act américain s'il est opéré par une entreprise relevant de ce droit.
En Europe, les droits viennent du RGPD
Le RGPD donne à chacun un droit d'accès à ses données, un droit à l'effacement, et un droit d'opposition quand le traitement repose sur l'intérêt légitime de l'éditeur, pour des raisons tenant à sa situation particulière ; l'éditeur peut continuer s'il démontre des motifs légitimes et impérieux. En décembre 2024, le comité européen de la protection des données a admis que cet intérêt puisse fonder le développement d'un assistant conversationnel, si le traitement est strictement nécessaire.
En janvier 2025, la Garante italienne a limité le traitement des données des personnes en Italie par DeepSeek, en relevant notamment le stockage en Chine et l'absence de représentant dans l'Union. Pour les éditeurs établis en Irlande, comme OpenAI ou Anthropic, l'autorité chef de file est l'autorité irlandaise : en mars 2026, la justice italienne a annulé pour cette raison l'amende de 15 millions d'euros que la Garante avait infligée à OpenAI.
L'AI Act, qui précise ne pas affecter le RGPD, change peu de choses pour une conversation. Il oblige les fournisseurs de modèles à usage général à publier un résumé des données qui ont servi à les entraîner, depuis le 2 août 2025 pour les modèles mis sur le marché depuis cette date et d'ici le 2 août 2027 pour les précédents ; ses règles de transparence s'appliquent depuis août 2026. La conservation des conversations et leur usage pour l'entraînement restent régis par le RGPD. Une révision du RGPD, l'omnibus numérique, est en discussion : les États membres ont arrêté leur position le 21 octobre 2026, le Parlement européen pas encore.
Notre recommandation pour les versions grand public
Pour nous, la règle la plus utile tient dans la question que l'État pose à ses agents avant d'utiliser une version gratuite : « Est-ce que je pourrais publier ces informations sur un site Internet accessible à tous ? » Les réglages réduisent ce que l'éditeur garde, sans fermer les chemins de la sécurité et de la justice. Une information qu'on ne publierait pas a sa place dans une offre sous contrat, ou hors de l'IA.
Pour une organisation, la question se règle avant le premier usage : dans le contrat, qui fixe l'entraînement et la durée de conservation, et dans la charte d'usage, qui dit quels comptes et quelles données sont permis.
Les règles des éditeurs changent souvent. Celles-ci ont été lues en novembre 2026, sauf celles d'OpenAI, reprises de la presse de 2025 et 2026 ; celle de Copilot vaut pour l'ancienne application. Ce sont des engagements déclarés : nous n'avons trouvé aucun audit public qui vérifie qu'un réglage est respecté. La pièce ne traite ni les comptes des mineurs ni l'usage des modèles par les développeurs.
Sources
45 documents
- Engadget, OpenAI no longer has to preserve all of its ChatGPT data, with some exceptions2025fiche 150
- VentureBeat, Sam Altman calls for AI privilege as OpenAI clarifies court order to retain temporary and deleted ChatGPT sessions2025fiche 186
- Gizmodo, OpenAI will stop saving most ChatGPT users' deleted chats2025fiche 151
- Press Gazette, OpenAI ordered to share 20 million ChatGPT user logs with news publishers2025fiche 152
- Google, Gemini adds Temporary Chats and new personalization features2025fiche 161
- PCWorld, Using ChatGPT? Change these 5 settings before you do anything else2026fiche 154
- Blog du Modérateur, Comment empêcher ChatGPT d'utiliser vos données pour entraîner ses modèles2025fiche 187
- Notebookcheck, ChatGPT: what the training toggle does not switch off2026fiche 155
- Google, Manage & delete your activity in Gemini Apps, consulté en novembre 20262026fiche 189
- Google, Gemini Apps Privacy Hub2026fiche 160
- Anthropic, Updates to our Consumer Terms and Privacy Policy2025fiche 163
- TechCrunch, Anthropic users face a new choice: opt out or share your data for AI training2025fiche 190
- Anthropic, How long do you store my data?2026fiche 164
- Microsoft, Microsoft Copilot privacy controls (ancienne application), consulté en novembre 20262026fiche 167
- Microsoft, Privacy FAQ for Microsoft Copilot (ancienne application), consulté en novembre 20262026fiche 191
- Meta, Making AI Work Harder for Europeans, avril 2025, mis à jour en mars 20262026fiche 172
- Mistral AI, Do you use my user data to train your artificial intelligence models?, consulté en novembre 20262026fiche 174
- Mistral AI, Can I opt out of my input or output data being used for training?2026fiche 175
- DeepSeek, Privacy Policy2026fiche 176
- DeepSeek, Terms of Use2026fiche 177
- CNIL, IA : comment s'opposer à la réutilisation de ses données personnelles pour l'entraînement d'agents conversationnels2025fiche 180
- WhatsApp, Privacy questions, consulté en novembre 20262026fiche 173
- Google Workspace, Generative AI in Google Workspace Privacy Hub2026fiche 162
- Futurism, compte rendu du billet d'OpenAI Helping people when they need it most2025fiche 158
- Anthropic, Privacy Policy, en vigueur le 10 septembre 20262026fiche 166
- Meta, Improving Your Recommendations on Our Apps With AI at Meta2025fiche 170
- TechCrunch, Meta plans to sell targeted ads based on data in your AI chats2025fiche 171
- Siècle Digital, La publicité arrive dans ChatGPT en France dès le 24 août2026fiche 188
- Trending Topics, Ads coming to ChatGPT Free and Go in Europe later this month2026fiche 156
- Microsoft, Privacy controls (nouvelle application Copilot)2026fiche 168
- Engadget, OpenAI is removing ChatGPT conversations from Google2025fiche 157
- Forbes Australia, reprise de Forbes, Elon Musk's xAI published hundreds of thousands of Grok chatbot conversations2025fiche 159
- Microsoft, Enterprise data protection in Microsoft Copilot and Microsoft Copilot Chat2026fiche 169
- Microsoft Learn, Claude models from Anthropic in Microsoft Online Services2026fiche 192
- Anthropic, Is my data used for model training?2026fiche 165
- DINUM, avec la DITP et la DGAFP, Guide d'usage de l'IA pour les agents publics de l'État, juin 2026, copie diffusée par l'UFETAM-CFDT2026fiche 185
- TechCrunch, Sam Altman warns there's no legal confidentiality when using ChatGPT as a therapist2025fiche 153
- Comité européen de la protection des données, communiqué sur l'avis 28/2024 sur les modèles d'IA2024fiche 178
- RGPD, chapitre III, droits de la personne concernée, texte publié par la CNIL2016fiche 179
- Garante per la protezione dei dati personali, décision n° 33 sur DeepSeek2025fiche 181
- Diritto.it, Open AI : annullata la sanzione del Garante privacy2026fiche 193
- AI Act, article 2, champ d'application, texte reproduit par l'Institut Future of Life2026fiche 183
- Commission européenne, AI Act, page mise à jour en octobre 20262026fiche 182
- AI Act, article 111, modèles déjà sur le marché, texte reproduit par l'Institut Future of Life2026fiche 194
- IAPP, EU member states finalize digital omnibus negotiating stance2026fiche 184
Chaque chiffre a été lu dans sa source ; la méthode du hub est décrite dans Méthode et sources.
Impact de l'IA, Projet Celsius, « Que deviennent les données confiées à une IA ? », 13 novembre 2026. https://projetcelsius.com/ia/analyses/que-deviennent-les-donnees-confiees-a-une-ia/

 Usages















