
 Société13 novembre 2026
L'IA nous rend-elle bêtes ?
Sondages, enquêtes et essais contrôlés




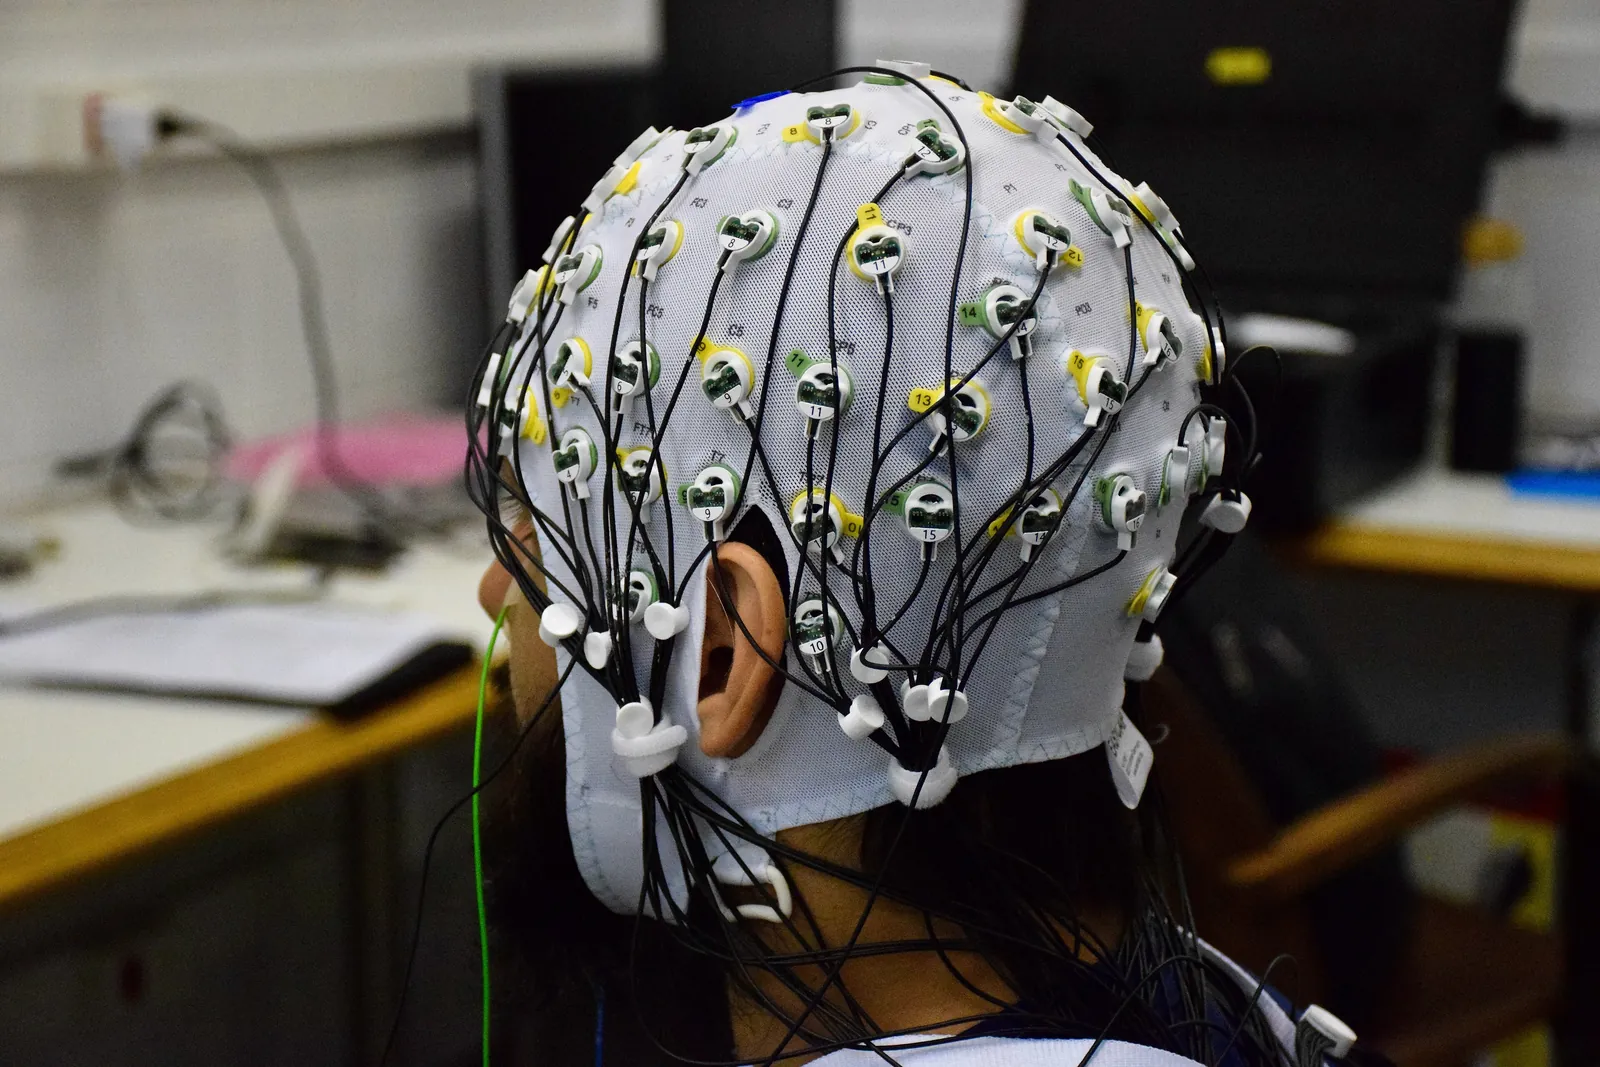
Un bonnet d'électroencéphalographie pendant une formation du centre de recherche NeuroMat, en janvier 2024. Photo Thaismay, CC BY-SA 4.0, via Wikimedia Commons.
Aucune des études que nous avons relevées ne mesure une baisse de l'intelligence chez ceux qui utilisent l'IA. Des essais tirés au sort mesurent un effet plus étroit : des élèves et des étudiants qui travaillent avec une IA qui donne les réponses obtiennent de moins bons résultats, ce qui ne s'est pas produit avec une IA réglée pour guider. Les études qui ont fait les titres sont parmi les moins solides.
Sommaire
Le 10 juin 2025, 8 chercheurs du MIT et de 2 établissements voisins ont mis en ligne une étude sur l'écriture de textes avec ChatGPT. 2 semaines plus tard, un quotidien belge titrait : « ChatGPT rend moins intelligent ». Sur le site de l'étude, les auteurs répondent pourtant « Non ! » à la question « peut-on dire que les modèles de langage nous rendent plus bêtes ? », et demandent qu'on n'emploie ni « stupide », ni « bête », ni « dégâts ». L'étude porte sur 54 personnes et n'avait pas paru dans une revue le 13 novembre 2026, 17 mois après sa mise en ligne.
La crainte est répandue. En janvier 2025, 44 % des Français de 18 à 75 ans citaient la baisse des capacités de réflexion parmi les principaux risques de l'IA générative.
Les études les plus citées et leurs mesures
Nous avons relevé les études qui mesurent les capacités ou l'effort de personnes utilisant l'IA générative, hors revues de littérature. Parmi les plus citées, 5 dépassent 950 citations dans OpenAlex, une base publique des publications scientifiques. Aucune ne mesure l'intelligence.
| Étude | Participants | Mesure | Résultat | Statut |
|---|---|---|---|---|
| Enquête d'une école de commerce suisse, 2025 | 666 personnes, questionnaires et entretiens | Usage des outils d'IA, scores d'esprit critique | Plus d'usage, moins d'esprit critique ; les plus jeunes dépendent le plus des outils et ont les scores les plus bas | Revue, avec un correctif |
| MIT, 2025 | 54 personnes, 3 textes de 20 minutes | Signaux électriques du cerveau pendant l'écriture, citation de son propre texte | À la 1re séance, aucun des 18 participants avec ChatGPT ne cite correctement son texte, contre 2 et 3 échecs sur 18 sans ; ensuite, 4 puis 6 échecs, contre 2 | Prépublication |
| Expérience sur la rédaction, 2024 | 117 étudiants tirés au sort | Note du texte, connaissances acquises | Texte mieux noté avec ChatGPT, sans plus de connaissances acquises qu'avec les autres aides | Revue |
| Microsoft Research et Carnegie Mellon, 2025 | 319 personnes qui utilisent l'IA au travail, 936 exemples | Esprit critique déclaré | Plus on fait confiance à l'IA, moins on déclare exercer son esprit critique | Actes de conférence relus |
| Lycée en Turquie, 2025 | Près de 1 000 élèves d'un même lycée, répartis au hasard entre les classes | Examen de mathématiques sans IA | 17 % de moins après des révisions avec une IA semblable à ChatGPT, sans garde-fou | Revue |
Dans l'ordre du tableau, 2 120, 1 436, 1 344, 996 et 976 citations dans OpenAlex le 13 novembre 2026. Sources : Gerlich, Societies ; Kosmyna et al., arXiv ; Fan et al., British Journal of Educational Technology ; Lee et al., CHI 2025 ; Bastani et al., PNAS.
2 de ces études mesurent l'esprit critique à un seul moment, par des scores ou par des déclarations. Les 3 autres tirent les groupes au sort et mesurent un effet le jour même. Nous avons écarté une autre étude très citée, sur des récits écrits avec l'aide de l'IA, parce qu'elle note les textes sans mesurer les capacités de leurs auteurs.
L'étude la plus citée est au plus bas niveau de preuve
La Haute Autorité de santé classe les études en 4 niveaux de preuve. Au niveau 1, les grands essais tirés au sort et les méta-analyses de ces essais. Au niveau 4, les études rétrospectives et les enquêtes qui décrivent une population à un moment donné. Notre échelle reprend cet ordre, avec en bas le sondage d'opinion, qui mesure une crainte, et en haut les méta-analyses, dont le niveau dépend des études qu'elles réunissent.
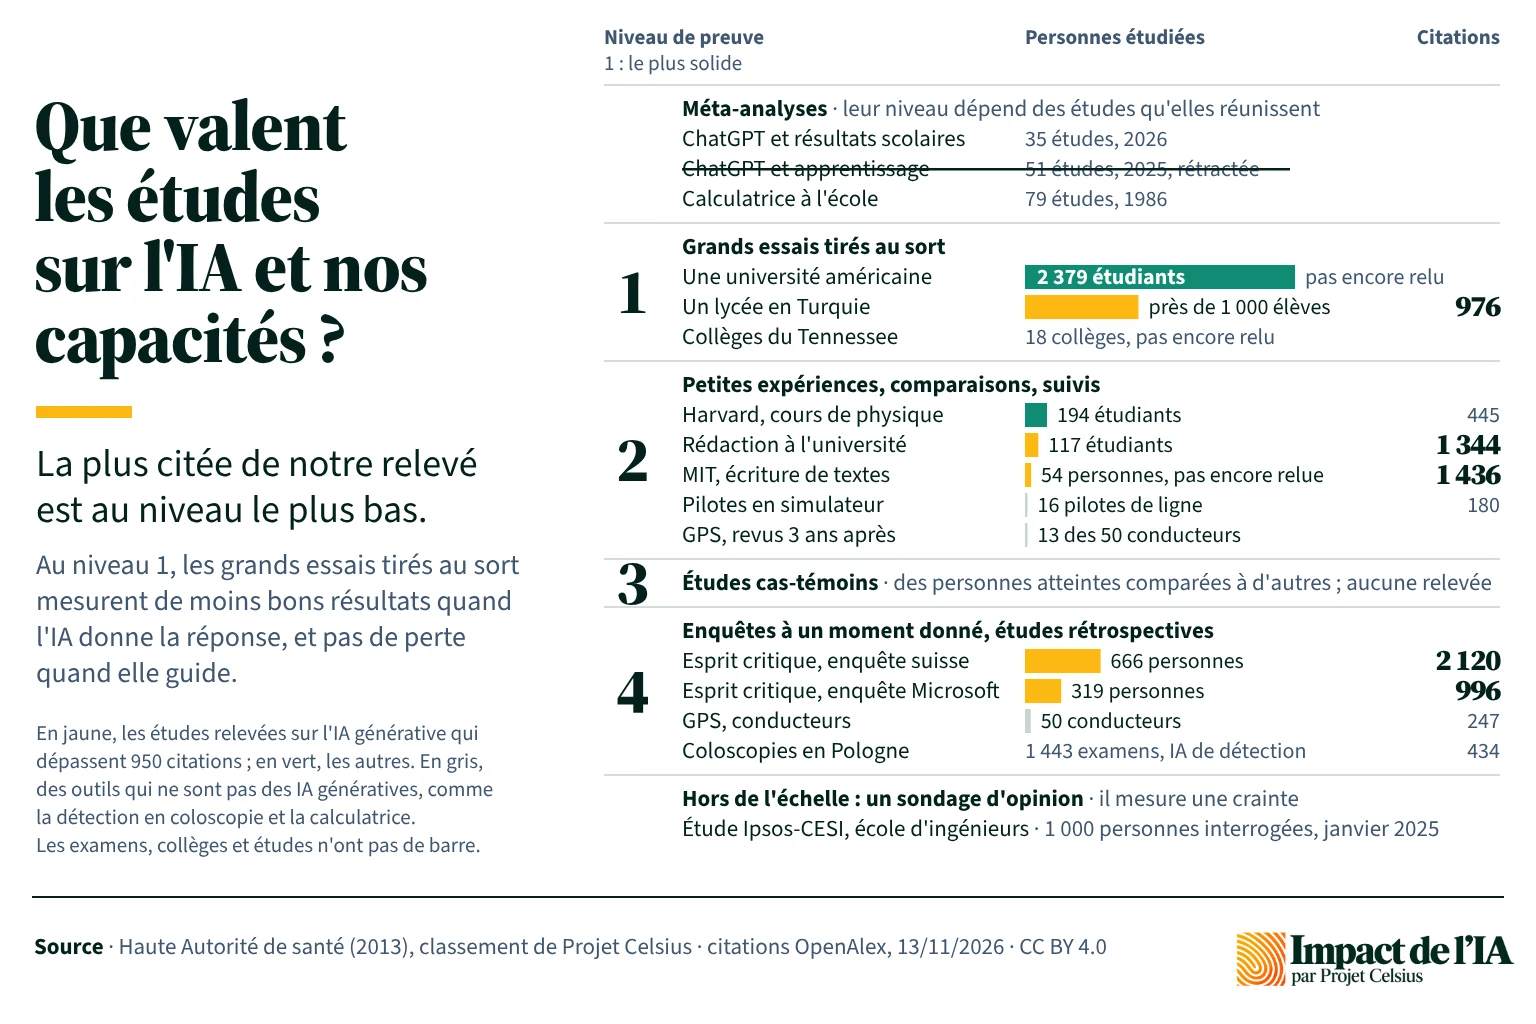
L'enquête suisse, la plus citée avec 2 120 citations, et celle de Microsoft sont au niveau 4. L'étude du MIT et l'expérience sur la rédaction tirent leurs groupes au sort sur de petits effectifs, au niveau 2. L'essai mené en Turquie, dans un seul lycée, est le seul des 5 au niveau 1, et le moins cité.
Les méta-analyses ne tranchent pas encore. En mars 2026, l'une d'elles, sur 35 études et 4 193 participants, trouvait un effet positif « modéré » de ChatGPT sur les résultats des élèves et des étudiants, en admettant des expériences sans tirage au sort aux résultats très dispersés. Une autre, qui concluait en mai 2025 à un effet « large », a été rétractée le 22 avril 2026 pour des incohérences dans l'analyse. 4 chercheurs ont audité une partie des expériences réunies par une troisième : selon eux, les gains observés ne peuvent pas encore être attribués avec confiance à ChatGPT.
Des essais mesurent un apprentissage moins bon avec une IA qui donne les réponses
À l'automne 2023, une cinquantaine de classes d'un lycée turc ont révisé les mathématiques en 4 séances de 90 minutes, chacune conclue par un examen sans aide. Chaque classe était affectée à l'un des 3 groupes : sans IA, avec une IA semblable à ChatGPT, ou avec une IA réglée avec les enseignants pour donner des indices plutôt que les réponses.
par rapport aux classes qui n'avaient jamais eu l'IA, avec une incertitude de 3 % à 30 % environ. Pendant les exercices, ces classes faisaient 48 % de mieux.
Les auteurs ont lu les échanges. Avec l'IA sans garde-fou, les élèves demandaient souvent la solution et la recopiaient. Ils n'ont pas eu l'impression d'avoir moins bien réussi l'examen.
Un essai plus grand, mis en ligne en septembre 2026 sans relecture par des pairs, va dans le même sens. Dans une université publique américaine, des cours tirés au sort ont reçu un tuteur IA réglé par défaut pour donner directement la réponse. L'essai porte sur 2 379 étudiants ; entre sections d'un même cours, la note finale a baissé de 0,37 écart-type, une mesure de la dispersion des notes. Les auteurs jugent délicat d'en tirer un effet sur l'apprentissage, la note étant celle de l'enseignant.
Dans l'essai mené en Turquie, la perte portait sur les exercices que l'IA avait faits à la place des élèves, et ceux-ci ne l'ont pas vue.
Pour une compétence déjà acquise, les preuves sont plus faibles
Des études plus petites, sur d'autres outils et sans tirage au sort, vont dans le même sens. À l'université McGill, à Montréal, 50 conducteurs avaient une mémoire spatiale d'autant moins bonne qu'ils avaient roulé au GPS ; 13 d'entre eux, revus 3 ans plus tard, avaient d'autant plus décliné qu'ils s'en étaient servis. Dans un simulateur de Boeing 747, 16 pilotes de ligne gardaient leurs gestes de pilotage manuel, mais peinaient à suivre la position de l'avion et à décider de l'étape suivante, d'autant plus que leur esprit vagabondait quand l'automatisation pilotait. Dans 4 centres d'endoscopie en Pologne, le taux de détection des adénomes, des polypes dont certains deviennent des cancers, est passé de 28,4 % à 22,4 % dans les coloscopies faites sans IA, dans les 3 mois qui ont suivi l'arrivée d'une IA de détection ; les auteurs écrivent que l'IA « pourrait » en être la cause.
Sur la grille de la Haute Autorité de santé, ces études donnent une présomption ou un faible niveau de preuve. Les chercheurs de Microsoft en rappellent le mécanisme supposé, « l'ironie de l'automatisation » décrite par Lisanne Bainbridge en 1983 : en confiant la routine à la machine, on prive l'utilisateur des occasions d'exercer son jugement.
Aucune étude relevée ne mesure l'intelligence
Les études qui s'en approchent le plus, l'enquête suisse et celle de Microsoft, relient un usage à des scores d'esprit critique ou à des déclarations. Une corrélation de ce type se lit dans les 2 sens : l'IA peut affaiblir l'esprit critique, et ceux qui l'exercent moins peuvent aussi se servir davantage de l'IA.
L'étude du MIT mesure des signaux du cerveau moins liés entre eux pendant l'écriture avec ChatGPT, et ne dit pas ce qu'il en reste des mois plus tard. 4 autres chercheurs demandent une lecture plus prudente de ses résultats, en relevant la petite taille de l'échantillon et des résultats rapportés de façon contradictoire.
2 études plus anciennes servent de précédents. En 2011, une étude parue dans Science concluait qu'on retient moins une information quand on s'attend à la retrouver sur un ordinateur ; une seule de ses 4 expériences, qui ne portait pas sur la mémoire, n'a pas été reproduite. En 1986, une méta-analyse de 79 études concluait que la calculatrice, utilisée avec un enseignement classique, améliorait le calcul au crayon des élèves de niveau moyen, sauf en CM1. L'article du blog sur ce que les études mesurent dans le cerveau constate qu'aucune des études qu'il cite ne mesure d'effet durable sur le cerveau.
La conception de l'outil décide de ce qu'on apprend
Au lycée turc, l'IA réglée pour donner des indices a fait disparaître presque toute la perte à l'examen, sans produire de gain. Dans 18 collèges du Tennessee, un essai de 2 ans, mis en ligne en août 2026 sans relecture par des pairs, a donné à des élèves tirés au sort un tuteur réglé pour guider plutôt que répondre : un petit gain en mathématiques, proche de celui des exercices de la même plateforme sans IA, avec des élèves qui le sollicitaient peu. À Harvard, 194 étudiants de physique ont progressé plus de 2 fois plus avec un tuteur qui les guidait étape par étape, sur des consignes des enseignants, qu'en cours de pédagogie active, sur un test passé juste après.
| Usage associé à une perte | Usage sans perte mesurée |
|---|---|
| L'outil donne la réponse pendant qu'on apprend (lycée et université, IA sans garde-fou) | L'outil guide ou donne des indices (lycée, IA réglée ; collèges du Tennessee ; Harvard) |
| La compétence n'est plus pratiquée, puis l'outil manque (GPS, coloscopie ; observations) | La pratique continue à côté de l'outil (calculatrice, sauf en CM1) |
Sources : Bastani et al. ; Liu et al. ; Oreopoulos et Low ; Kestin et al. ; Dahmani et Bohbot ; Budzyń et al. ; Hembree et Dessart. GPS et coloscopie : des observations, sur des outils qui ne sont pas des IA génératives.
Parmi les études relevées, aucune de celles publiées dans une revue ne suit les mêmes personnes au-delà de quelques mois avec une IA générative.
Notre lecture
Pour nous, rien de ce que nous avons lu ne montre que l'IA rende bête. Les études éclairent une question plus étroite : quelles tâches l'outil fait-il à notre place, et en aura-t-on besoin le jour où il manquera ? Un élève qui apprend à résoudre une équation, un médecin qui repère des polypes et un pilote qui doit savoir où est son avion en ont besoin, et l'on ne sait pas toujours d'avance quelle tâche il faudra refaire seul.
Dans un Bilan Carbone®, chaque donnée reçoit une incertitude : un relevé de compteur vaut mieux qu'une estimation, et une estimation qu'un ratio moyen. Appliquée à ce débat, la même règle place les essais tirés au sort au-dessus des études qui ont fait les titres. Avant de déployer un assistant dans une classe ou une équipe, nous poserions la question que ces essais ont testée : l'outil donne-t-il la réponse, ou aide-t-il à la chercher ?
L'étude du MIT est une prépublication, que d'autres chercheurs n'ont pas encore relue ; les essais de l'université américaine et des collèges du Tennessee sont des documents de travail. L'essai mené en Turquie porte sur un seul lycée et sur le court terme. Les études sur le GPS, les pilotes et les coloscopies portent sur des outils qui ne sont pas des IA génératives, avec un niveau de preuve faible. Les nombres de citations viennent d'OpenAlex au 13 novembre 2026 et ne couvrent que les études que nous avons relevées. Le classement des études par niveau de preuve est le nôtre, d'après la grille de la Haute Autorité de santé.
Sources
24 documents
- Kosmyna, Hauptmann, Yuan et al., Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task, prépublication arXiv, juin 2025 (version 2 de décembre 2025)2025fiche 95
- Kosmyna et al., Your Brain on ChatGPT, questions fréquentes du site de l'étude, lues le 13 novembre 20262025fiche 96
- Stankovic, Hirche, Kollatzsch et Doetsch, Comment on: Your Brain on ChatGPT, prépublication arXiv2025fiche 97
- Michael Gerlich, AI Tools in Society: Impacts on Cognitive Offloading and the Future of Critical Thinking, Societies, janvier 2025 (correctif de septembre 2025)2025fiche 98
- Lee, Sarkar, Tankelevitch, Drosos, Rintel, Banks et Wilson, The Impact of Generative AI on Critical Thinking: Self-Reported Reductions in Cognitive Effort and Confidence Effects From a Survey of Knowledge Workers, actes de CHI 20252025fiche 99
- Fan, Tang, Le et al., Beware of metacognitive laziness: Effects of generative artificial intelligence on learning motivation, processes, and performance, British Journal of Educational Technology2024fiche 100
- Bastani, Bastani, Sungu, Ge, Kabakcı et Mariman, Generative AI without guardrails can harm learning: Evidence from high school mathematics, PNAS2025fiche 101
- Liu, Sweet, Chen et al., The Effects of Course-Integrated AI Tutoring on Student Performance and Engagement: A Randomized University Trial, EdWorkingPaper 26-1598, Annenberg Institute (université Brown)2026fiche 116
- Oreopoulos et Low, One Click Away: AI Tutoring with Khanmigo in a Two-Year School Experiment, NBER2026fiche 117
- Kestin, Miller, Klales, Milbourne et Ponti, AI tutoring outperforms in-class active learning: an RCT introducing a novel research-based design in an authentic educational setting, Scientific Reports2025fiche 102
- Budzyń, Romańczyk et al., Endoscopist deskilling risk after exposure to artificial intelligence in colonoscopy: a multicentre, observational study, The Lancet Gastroenterology & Hepatology2025fiche 103
- Dahmani et Bohbot, Habitual use of GPS negatively impacts spatial memory during self-guided navigation, Scientific Reports2020fiche 104
- Casner, Geven, Recker et Schooler, The Retention of Manual Flying Skills in the Automated Cockpit, Human Factors2014fiche 105
- Sparrow, Liu et Wegner, Google effects on memory: cognitive consequences of having information at our fingertips, Science2011fiche 106
- Guido Hesselmann, No conclusive evidence that difficult general knowledge questions cause a « Google Stroop effect ». A replication study, PeerJ2020fiche 107
- Hembree et Dessart, Effects of Hand-Held Calculators in Precollege Mathematics Education: A Meta-Analysis, Journal for Research in Mathematics Education1986fiche 108
- Wu, Zhu, Zhang, Yin et Wang, ChatGPT's impact on student learning outcomes: a meta-analysis of 35 experimental studies, Humanities and Social Sciences Communications2026fiche 110
- Wang et Fan, The effect of ChatGPT on students' learning performance, learning perception, and higher-order thinking: insights from a meta-analysis, Humanities and Social Sciences Communications, mai 2025, rétractée le 22 avril 2026 (avis de rétractation)2026fiche 109
- Weidlich, Gašević, Drachsler et Kirschner, ChatGPT in Education: An Effect in Search of a Cause, Journal of Computer Assisted Learning2025fiche 111
- Doshi et Hauser, Generative AI enhances individual creativity but reduces the collective diversity of novel content, Science Advances2024fiche 118
- Haute Autorité de santé, Niveau de preuve et gradation des recommandations de bonne pratique, état des lieux2013fiche 113
- Étude Ipsos-CESI, école d'ingénieurs, L'usage de l'intelligence artificielle par les Français2025fiche 112
- OpenAlex, nombre de citations de chaque étude, relevé du 13 novembre 20262026fiche 114
- La DH, ChatGPT rend moins intelligent : une nouvelle étude montre les effets inquiétant de l'IA sur le cerveau2025fiche 115
Chaque chiffre a été lu dans sa source ; la méthode du hub est décrite dans Méthode et sources.
Impact de l'IA, Projet Celsius, « L'IA nous rend-elle bêtes ? », 13 novembre 2026. https://projetcelsius.com/ia/analyses/l-ia-nous-rend-elle-betes/