
 Matériel13 novembre 2026
Pourquoi l'IA a-t-elle besoin de cartes graphiques ?
Le calcul, la mémoire, l'électricité et la fabrication d'une carte H100




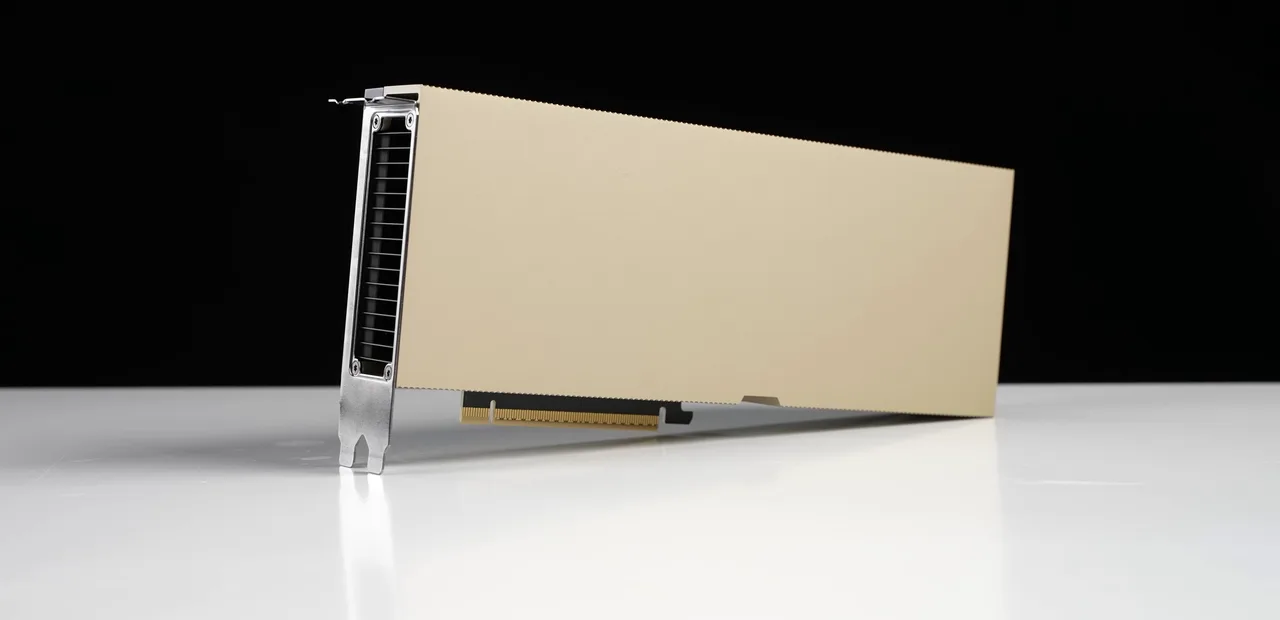
Une carte graphique Nvidia H100 au format PCIe, version pour serveurs ordinaires, de 350 W ; les chiffres du texte portent sur la version SXM, montée par 8 dans les serveurs d'IA. Image tirée d'une vidéo de Geekerwan (极客湾), juin 2023, CC BY 3.0, via Wikimedia Commons.
Pour écrire chaque mot, un modèle de langage dense fait une multiplication et une addition pour chacun de ses milliards de paramètres, et doit les relire tous en mémoire. Une carte graphique fait ces opérations par milliers en même temps ; la H100 SXM, montée par 8 dans les serveurs d'IA, lit sa mémoire à 3,35 téraoctets par seconde. Une heure de travail de cette carte consomme environ 0,99 kWh, sa part du serveur et du centre de données comprise, selon l'estimation de la Base Impact de l'IA ; sa fabrication a émis de 164 à 235 kgCO2e selon les estimations de Nvidia et de l'ADEME.
Sommaire
Un modèle de langage est un très grand ensemble de nombres, ses paramètres, rangés en tableaux, les matrices. Le calcul qui suit vaut pour un modèle dit dense, qui utilise tous ses paramètres pour chaque mot ; les modèles à mélange d'experts n'en utilisent qu'une partie, par exemple 13 milliards sur 47 pour Mixtral 8x7B de Mistral AI. Pour écrire un mot, plus exactement un morceau de mot, le modèle fait passer la suite du texte à travers ces tableaux : chaque paramètre y est multiplié par un nombre, puis le résultat est additionné aux autres. Le guide de Nvidia sur ce calcul le résume ainsi : chaque multiplication suivie d'une addition compte pour 2 opérations.
Pour un modèle de 70 milliards de paramètres, cela fait environ 140 milliards d'opérations par mot. Ces opérations sont indépendantes les unes des autres et peuvent se faire en même temps. C'est le travail pour lequel les cartes graphiques ont été conçues, à l'origine pour calculer en parallèle les points d'une image, et qu'elles font aujourd'hui pour les réseaux de neurones.
Calcul en parallèle
La carte H100 de Nvidia, dans sa version SXM montée par 8 dans les serveurs d'IA, porte une puce de 80 milliards de transistors, gravée par TSMC. Elle compte 16 896 cœurs de calcul et 528 cœurs spécialisés dans les produits de matrices, que Nvidia appelle Tensor Cores. Ses Tensor Cores font jusqu'à 989 000 milliards d'opérations par seconde sur des nombres de 16 bits, le double sur des nombres de 8 bits. Début 2025, la génération de la H100 et de ses variantes représentait 77 % de la puissance de calcul de toutes les puces d'IA de Nvidia en service, selon Epoch AI.
Un processeur d'ordinateur ou de serveur sait enchaîner des tâches variées, mais il mène beaucoup moins d'opérations de front. Pour un réseau de neurones, où les mêmes opérations se répètent sur des milliards de nombres, le nombre d'opérations menées en même temps l'emporte.
Mémoire de la carte
Pour écrire chaque mot, la carte doit relire tous les paramètres d'un modèle dense dans sa mémoire. Une H100 porte 80 Go de mémoire HBM3, empilée autour de la puce, qu'elle lit à 3,35 téraoctets par seconde. Un modèle de 70 milliards de paramètres stockés sur 16 bits, soit 2 octets chacun, occupe 140 Go : il lui faut au moins 2 cartes.
Notre calcul, en ordre de grandeur, pour une seule demande à la fois sur ces 2 cartes : relire les 140 Go prend environ 21 millièmes de seconde, et faire les 140 milliards d'opérations environ 70 millionièmes de seconde. La carte attend donc sa mémoire environ 300 fois plus longtemps qu'elle ne calcule. Le guide de Nvidia écrit qu'un produit d'une matrice par un vecteur est toujours limité par la mémoire ; c'est la forme du calcul quand on écrit un seul mot pour une seule demande.
| Étape, pour 1 mot | Quantité | Débit de 2 cartes H100 | Durée |
|---|---|---|---|
| Relire les paramètres du modèle | 140 Go | 6,7 To/s | environ 21 ms |
| Faire les opérations | 140 milliards | 1 978 000 milliards par seconde | environ 0,07 ms |
Notre calcul, pour un modèle de 70 milliards de paramètres stockés sur 16 bits, une seule demande à la fois, sans compter la mémoire du texte déjà lu. Débits maximaux de Nvidia ; en service, ils ne sont pas atteints en continu.
C'est pourquoi les services d'IA regroupent les demandes de nombreux utilisateurs : une même lecture des paramètres sert alors à écrire un mot pour chacune d'elles, et l'électricité par demande baisse. Notre analyse sur l'IA installée sur son ordinateur mesure cet effet. La mémoire est aussi le premier poste de fabrication de la carte mère H100 selon Nvidia, avec 42 % des émissions, devant les puces, 25 %.
Électricité d'une carte en 1 heure
Une H100 SXM a une puissance nominale de 700 W. Elle ne travaille pas seule : le serveur DGX H100 de Nvidia, qui en réunit 8, consomme au plus 10,2 kW avec ses processeurs, sa mémoire, son réseau et ses ventilateurs, soit 1 275 W par carte. Les mesures publiées par des chercheurs de Microsoft sur la génération précédente trouvent une puissance qui atteint ou dépasse la puissance nominale quand le modèle lit la demande, et plus basse quand il écrit la réponse.
La Base Impact de l'IA retient 900 Wh pour une heure de carte, 70 % de la part de la carte dans la puissance maximale du serveur, 1 275 W, la charge moyenne que retient Epoch AI. Avec le refroidissement et le reste du centre de données, l'heure atteint 0,99 kWh, soit 0,45 kgCO2e avec l'électricité moyenne du monde, autant que 3 km en voiture thermique, construction de la voiture comprise, sans la fabrication du serveur. Ce sont des estimations : aucune mesure de la consommation moyenne d'une H100 en service n'a été publiée.
Une heure de carte H100, centre de données compris, comparée à des repères (kgCO2e, électricité moyenne du monde)
Émissions de fabrication d'une carte
Nvidia a publié en 2025 l'empreinte de fabrication de sa carte mère HGX H100, qui porte 8 cartes : 1 312 kgCO2e, de l'extraction des matières à l'assemblage, soit 164 kgCO2e par carte. La mémoire en est le premier poste, avec 42 %, devant les puces de calcul et de réseau, 25 %. L'ADEME, avec son propre modèle, estime une carte H100 seule à 235 kgCO2e, et note que la méthode de Nvidia est peu transparente.
 Matériel
Fabrication d'un serveur d'IA, par composant
Carte mère Nvidia HGX H100 à 8 cartes graphiques, 1 312 kgCO2e, part de chaque composant · Fiche publiée par Nvidia
Source : Nvidia, HGX H100 Product Carbon Footprint · projetcelsius.com/ia · CC BY 4.0
Le serveur entier émet davantage à fabriquer que sa carte mère et ses 8 cartes, d'après une étude simplifiée de GreenIT. GreenIT estime la fabrication, la distribution et la fin de vie d'un serveur d'entrée de gamme à 8 H100 à 8 341 kgCO2e, environ 1 000 kg par carte. Répartie sur 5 ans de service utilisés à 69 %, cette fabrication représente environ 35 gCO2e par heure de carte, soit environ 8 % de plus que l'électricité de l'heure avec l'électricité moyenne du monde, et 17 % avec celle de l'Union européenne.
Cartes livrées par Nvidia
Epoch AI estime, à partir des résultats financiers de Nvidia, que l'entreprise a livré environ 4,5 millions de cartes de centre de données en 2025, contre 1,3 million en 2023. La puissance maximale des cartes livrées en 2025 atteint à elle seule 4,9 GW, sans les serveurs ni le refroidissement. Ce sont des estimations, avec une incertitude qui atteint souvent un facteur 2. Greenpeace Asie de l'Est estime l'électricité consommée pour fabriquer les puces d'IA à 218 GWh en 2023 pour Nvidia seul, et à 983,9 GWh en 2024 pour Nvidia et AMD ; le graphique de l'électricité de fabrication des puces montre ces 2 années et la part de la hausse qui vient de l'ajout d'AMD.
Notre lecture
Pour nous, au Projet Celsius, la carte graphique éclaire 2 traits de l'empreinte de l'IA. Le premier : avec l'électricité moyenne du monde, l'électricité d'une heure de carte émet environ 13 fois plus que la part de fabrication du serveur qui lui revient, et environ 6 fois plus avec celle de l'Union européenne ; la taille du modèle et le nombre de demandes servies fixent le nombre de cartes mobilisées. Le second : la mémoire limite la vitesse d'écriture, et elle est aussi le premier poste de fabrication de la carte mère H100 selon Nvidia (42 %) comme de la génération suivante, la HGX B200 (49 %), dont la fabrication émet 1,7 fois plus. Ces chiffres viennent des fiches de Nvidia, les seules publiées pour ces cartes.
La consommation d'une heure de carte est une estimation : la charge moyenne de 70 % vient de mesures sur la génération précédente, et aucune mesure publiée ne porte sur une H100 en service. La fabrication d'une carte va de 164 à 235 kgCO2e selon la méthode, et environ 1 000 kg pour sa part du serveur entier, distribution et fin de vie comprises, selon une étude simplifiée de GreenIT.
Sources
16 documents
- Nvidia, Matrix Multiplication Background User's Guide2023fiche 354
- Nvidia, NVIDIA Hopper Architecture In-Depth, billet technique2022fiche 352
- Nvidia, NVIDIA H100 Tensor Core GPU, caractéristiques techniques2023fiche 351
- Nvidia, DGX H100/H200 User Guide, Introduction to the NVIDIA DGX H100/H200 System2024fiche 353
- Epoch AI, How much energy does ChatGPT use?2025fiche 20
- Patel et al. (Microsoft Azure), Characterizing Power Management Opportunities for LLMs in the Cloud2024fiche 357
- Projet Celsius, Base Impact de l'IA, base de données environnementales de l'intelligence artificielle, moteur 0.3.12026fiche 144
- ADEME, Impact CO2, transport2026fiche 122
- Nvidia, HGX H100 Product Carbon Footprint Summary2025fiche 18
- Nvidia, HGX B200 Product Carbon Footprint Summary2025fiche 19
- ADEME, Analyse de cycle de vie de GPU pour l'intelligence artificielle, février 2026 (copie hébergée par lafibre.info)2026fiche 355
- GreenIT, Impacts environnementaux et sanitaires de l'intelligence artificielle dans le monde en 2025 et 20302026fiche 6
- Epoch AI, AI chip sales, estimations par puce et par trimestre (fichier CSV)2026fiche 356
- Epoch AI, The stock of computing power from NVIDIA chips is doubling every 10 months2025fiche 358
- Greenpeace Asie de l'Est, Chipping Point2025fiche 44
- Jiang et al. (Mistral AI), Mixtral of Experts, prépublication arXiv2024fiche 359
Chaque chiffre a été lu dans sa source ; la méthode du hub est décrite dans Méthode et sources.
Impact de l'IA, Projet Celsius, « Pourquoi l'IA a-t-elle besoin de cartes graphiques ? », 13 novembre 2026. https://projetcelsius.com/ia/analyses/pourquoi-l-ia-a-besoin-de-cartes-graphiques/
 Eau
 Électricité