
 Électricité13 novembre 2026
Une IA installée sur son ordinateur consomme-t-elle moins ?
La même réponse, dans un centre de données et sur sa machine




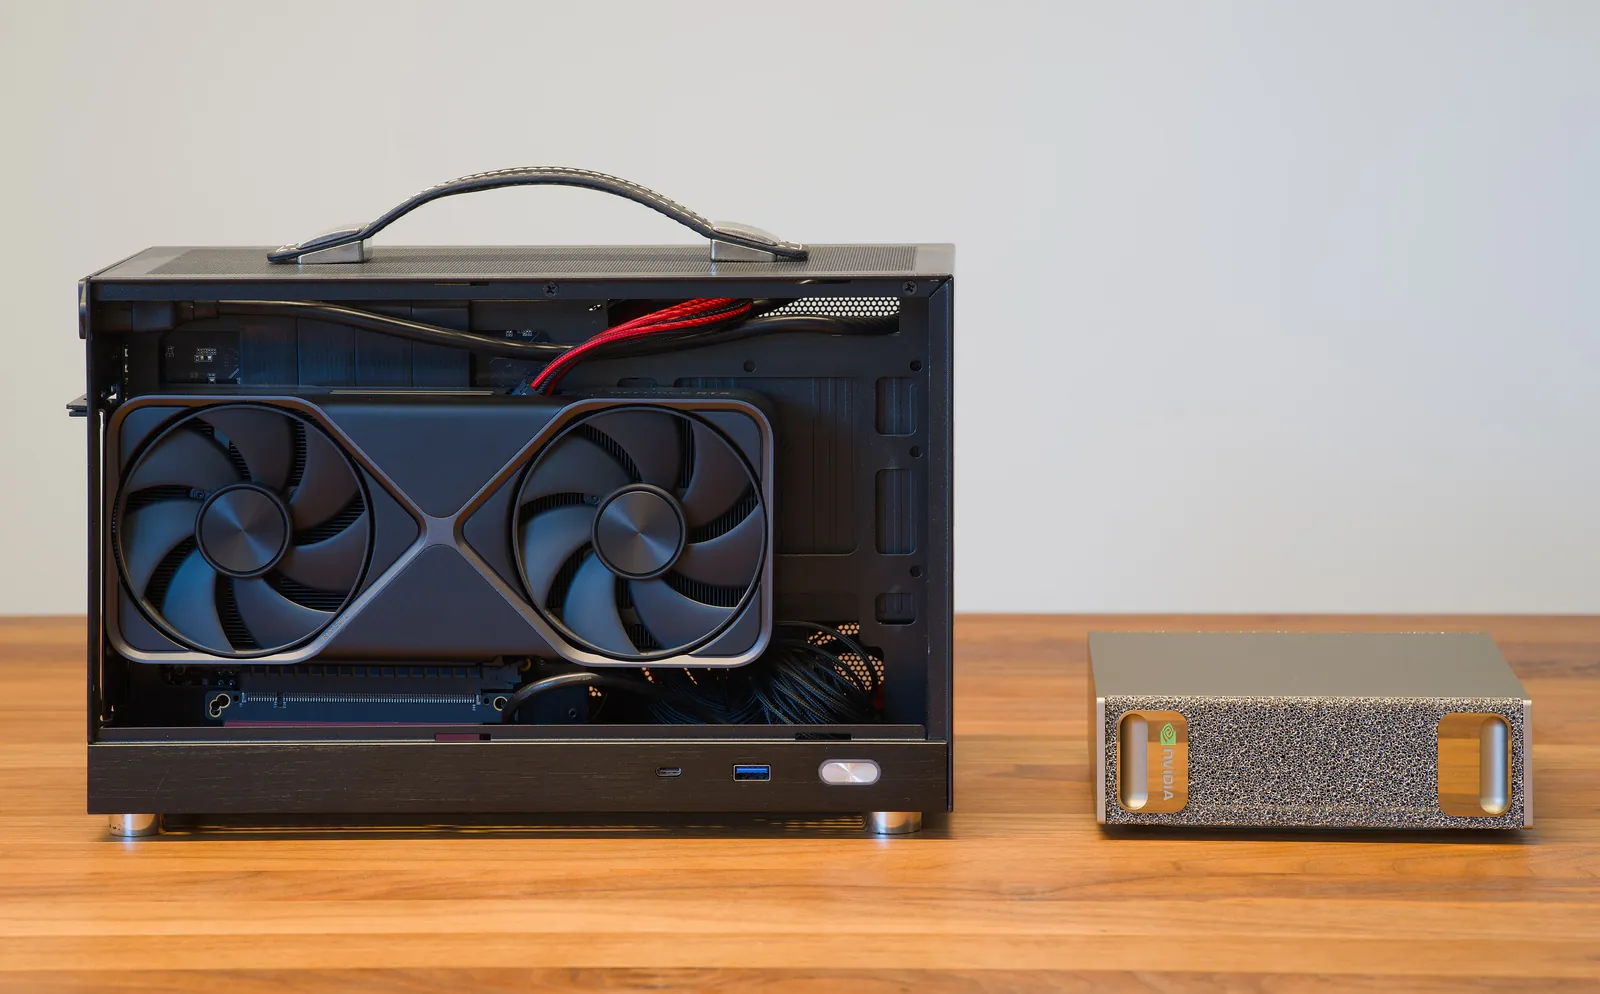
Un petit ordinateur de bureau ouvert sur sa carte graphique, à côté d'un DGX Spark, ordinateur d'IA de bureau vendu par Nvidia, en mai 2026. Photo Daniel Lu (dllu), CC BY-SA 4.0, via Wikimedia Commons.
Elle consomme moins quand son modèle est plus petit que celui du service en ligne : un modèle de 2 à 8 milliards de paramètres dépense 0,06 à 0,24 Wh pour une réponse d'une demi-page sur un ordinateur portable, d'après des mesures du processeur et de la carte graphique ramenées à cette longueur par notre calcul, contre 0,3 Wh estimés pour le modèle moyen d'un assistant. Servi à de nombreux utilisateurs à la fois, le même petit modèle dépenserait probablement moins dans un centre de données, qui partage chaque puce entre plusieurs demandes. Chez soi, l'électricité change le CO2e, et un ordinateur acheté pour cela ajoute une fabrication qui pèse autant de CO2e que l'électricité de 1,3 million de réponses du modèle moyen, comptée avec l'électricité moyenne du monde (notre calcul).
Sommaire
Des logiciels gratuits permettent d'installer un modèle d'IA ouvert sur son ordinateur, PC ou Mac, et les téléphones récents en embarquent un. La question revient avec ces IA locales : une réponse calculée chez soi, sans centre de données, consomme-t-elle moins ?
Nous avons suivi la même réponse sur les 2 chemins, dans une seule unité : l'électricité d'une réponse d'une demi-page, 400 tokens (les morceaux de mots que le modèle écrit), la question rapide de la Base Impact de l'IA.
Dans un centre de données, l'électricité des puces, des serveurs, des machines tenues en réserve et du bâtiment. Sur un ordinateur, celle du processeur et de la carte graphique pendant le calcul.
L'écran et le reste de l'appareil, allumés dans les 2 cas, et plus longtemps quand le calcul se fait sur la machine ; l'entraînement du modèle et, jusqu'à la dernière partie, la fabrication du matériel.
À modèle égal, le partage des puces avantage le centre de données
Un ordinateur ne sert qu'une personne. Un serveur traite plusieurs demandes en même temps sur la même puce, et partage entre elles sa consommation. Des chercheurs de Stanford et de Together AI l'ont mesuré sur une carte de centre de données, la B200 de Nvidia, avec un même modèle de 8 milliards de paramètres : l'énergie d'une question passe de 6 449 à 548 joules quand la carte en sert 64 à la fois au lieu d'une, une division par 12. Leurs questions, conversations et raisonnement, ont une longueur qui n'est pas publiée.
La même étude compare aussi la puce d'un Mac Studio à celle de la B200, une demande à la fois. Elle attribue à la seule partie graphique du Mac 240 à 305 W, plus que les 145 W qu'Apple publie au maximum pour la machine entière dans sa configuration de base ; nous ne retenons pas son rapport entre les 2 puces. Avec 145 W et les durées de réponse de l'étude, le Mac dépenserait environ 6 200 joules par question avec le même modèle de 8 milliards de paramètres, autant que la B200 qui sert une seule demande, d'après notre calcul. Une demande à la fois, aucun écart entre les 2 puces n'est établi.
Mesure, carte graphique de 2019, une seule demande à la fois.
- compté : Processeur et carte graphique
- pas compté : Mémoire, carte mère et écran
Estimation de la Base, puces partagées entre de nombreuses demandes.
- compté : Puces, serveurs, réserve et bâtiment
- pas compté : Mesure de ce modèle en production
Servi à de nombreux utilisateurs, le même modèle dépenserait donc probablement moins dans un centre de données. L'écart avec une machine récente n'est pas mesuré, et le matériel local a nettement progressé depuis 2019, d'après la même étude de Stanford.
Le centre de données ajoute en échange des étapes que l'ordinateur n'a pas. Google a publié la décomposition de la question médiane posée à Gemini en mai 2025, à notre connaissance la seule mesure de ce genre publiée par un éditeur sur son propre service.
| Étape | Électricité | Part du total |
|---|---|---|
| Puces d'IA en calcul | 0,14 Wh | 58 % |
| Processeurs et mémoire des serveurs | 0,06 Wh | 25 % |
| Machines tenues en réserve | 0,02 Wh | 10 % |
| Refroidissement et pertes du bâtiment | 0,02 Wh | 8 % |
| Total | 0,24 Wh | 100 % |
Question texte médiane posée à l'application Gemini, mai 2025, mesure de Google. Le réseau, l'appareil de l'utilisateur, l'entraînement et la fabrication ne sont pas comptés. Parts arrondies par Google.
Les machines en réserve et le bâtiment font 17 % du total. Chez un grand exploitant, le refroidissement ajoute environ un dixième à l'électricité des serveurs ; la Base retient ce coefficient à 1,10, et rappelle qu'un exploitant inconnu se compte à 1,56. Le trajet sur le réseau pèse moins encore. Le texte d'une question et de sa réponse fait environ 2 kilooctets ; même 100 kilooctets échangés, comptés avec le facteur établi pour 2015 par Aslan et ses coauteurs (0,06 kWh par gigaoctet), font 0,006 Wh, 2 % d'une question rapide, d'après notre calcul. Ce facteur baissait alors de moitié tous les 2 ans environ.
Une IA installée consomme moins quand son modèle est plus petit
Installer une IA sur son ordinateur revient presque toujours à changer de modèle. La mémoire de la machine fixe la taille de ce qu'elle peut faire tourner : le plus grand modèle local de l'étude de Stanford, gpt-oss-120b, tient, compressé sur 4 bits, dans les 128 Go de mémoire du Mac de l'étude, et un téléphone de 8 Go fait tourner des modèles compressés de quelques milliards de paramètres. La plupart des éditeurs ne publient pas la taille des modèles de leurs assistants ; la Base range le modèle servi par défaut dans une classe moyenne, et les modèles de pointe à plusieurs centaines de milliards de paramètres.
| Modèle et machine | Électricité d'une réponse d'une demi-page | Nature du chiffre |
|---|---|---|
| Grand modèle de pointe, centre de données | 1,2 Wh | Estimation de la Base |
| Modèle moyen d'un assistant, centre de données | 0,3 Wh | Estimation de la Base, calée sur des mesures et des déclarations d'éditeurs |
| Modèle de 8 milliards de paramètres, ordinateur portable à carte graphique de 2019 | 0,21 Wh | Mesure, ramenée à 400 tokens |
| Modèles de 7 milliards de paramètres, même portable | 0,16 à 0,24 Wh | Mesures, ramenées à 400 tokens |
| Modèles de 2 milliards de paramètres, même portable | 0,06 à 0,10 Wh | Mesures, ramenées à 400 tokens |
| Modèle de 8 milliards de paramètres, centre de données | 0,05 Wh | Estimation de la Base |
Centre de données : Base Impact de l'IA, moteur 0.3.1, question rapide, centre de données compris. Ordinateur : Husom et al. (SINTEF), 2026, processeur et carte graphique seuls (Intel Core i7 de 10e génération, Nvidia Quadro RTX 4000), réponses de 160 à 300 tokens ramenées à 400 par notre calcul. Les 2 groupes n'ont ni le même matériel ni le même périmètre.
Avec un modèle de 2 à 8 milliards de paramètres, le portable dépense 20 à 80 % de l'électricité du modèle moyen d'un assistant, et 5 à 20 % de celle d'un grand modèle, d'après notre calcul. Dans leur simulation d'un service qui envoie chaque demande vers un petit modèle local quand il suffit, et vers un grand modèle en ligne sinon, les chercheurs de Stanford obtiennent 60 à 80 % d'énergie en moins, et attribuent l'essentiel du gain à la taille des modèles plutôt qu'à l'efficacité du matériel. Leur point de départ est un service qui enverrait toutes les demandes à un modèle de 235 milliards de paramètres. Notre analyse sur la décarbonation de l'IA retient 27,8 % pour le plus petit modèle suffisant, à partir des modèles ouverts pondérés par leurs téléchargements.
Un petit modèle ne rend pas toujours le même service. Dans la même étude, un modèle de 8 milliards de paramètres répond correctement à 57,5 % des questions, et gpt-oss-120b, le meilleur modèle local pris seul, à 71,4 %, quand Gemini 2.5 Pro en réussit 66,5 à 89,5 % selon le banc d'essai. Une réponse insuffisante se redemande, et son électricité s'ajoute.
Ces chiffres ne se comparent pas au point près. La mesure du portable ne compte que le processeur et la carte graphique : c'est une borne basse de ce que tire la prise, sans la mémoire, la carte mère ni les pertes du chargeur. Celles du centre de données comptent tout le bâtiment. Sa carte graphique date de 2019, et une machine récente dépense nettement moins, d'après la même étude de Stanford. Les valeurs de la Base sont des estimations, que les éditeurs ne permettent pas de vérifier modèle par modèle.
Le gain d'une IA installée sur son ordinateur vient du modèle plus petit qu'elle fait tourner ; servi à de nombreux utilisateurs, le même modèle dépenserait probablement moins dans un centre de données, selon l'estimation de la Base.
Sur un téléphone, le modèle est plus petit encore
Apple équipe ses appareils d'un modèle d'environ 3 milliards de paramètres, stockés sur 2 bits chacun, et fait tourner un modèle plus grand sur ses propres serveurs. Sur un iPhone 16 Pro, l'étude de Stanford fait tourner un modèle de 4 milliards de paramètres, compressé sur 4 bits, à 9,5 W : 23 fois moins de puissance que la station de travail à carte Nvidia testée avec le même modèle, mais 15 fois plus de temps, 37 secondes par question. Cela fait environ 0,1 Wh par question de l'étude, d'après notre calcul. Le téléphone répond correctement à 38 % des questions, contre 44,5 % pour la station ; par unité d'énergie, il donne pourtant plus de bonnes réponses qu'elle.
L'électricité française divise par 11 le CO2e d'une réponse
Calculée chez soi, une réponse consomme l'électricité du domicile. L'électricité produite en France émettait en 2025 41 gCO2e par kWh sur son cycle de vie, 11 fois moins que la moyenne mondiale (458 g) et 9 fois moins que celle des États-Unis (384 g). Les éditeurs ne publient pas le pays où une question est traitée ; la Base compte par défaut l'électricité moyenne du monde. La carte du hub donne chaque pays.
| Réponse d'une demi-page | Électricité de la France | Électricité moyenne du monde |
|---|---|---|
| Modèle de 8 milliards de paramètres sur un portable (0,21 Wh) | 0,009 gCO2e | 0,096 gCO2e |
| Modèle moyen d'un assistant en centre de données (0,3 Wh) | 0,012 gCO2e | 0,14 gCO2e |
Électricité seule, production en cycle de vie, 2025 (Ember, via Our World in Data). Calcul du hub. Chaque colonne compare les 2 réponses à électricité égale.
À électricité égale, les 2 réponses gardent le rapport de leurs wattheures. Une réponse calculée en France gagne sur l'électricité française, dont un centre de données installé en France profiterait aussi.
Le calcul chez soi retire aussi l'eau que le centre de données consomme pour se refroidir : 0,26 mL pour la question médiane à Gemini selon Google, environ 5 gouttes. L'eau des centrales qui produisent l'électricité reste dans les 2 cas. Notre article sur l'empreinte eau de l'IA détaille ces périmètres.
Un ordinateur acheté pour l'IA pèse plus lourd que ses réponses
Un ordinateur en service a déjà été fabriqué, et y installer un modèle ne change rien à sa fabrication. Le compte change quand la machine est achetée pour cela, avec plus de mémoire ou une carte graphique.
Selon l'ADEME, un ordinateur portable moyen pèse 182 kgCO2e pour sa fabrication et sa distribution, sur un cycle de vie de 193 kg. Acheté pour faire tourner des modèles et gardé 5 ans, la durée que retient l'ADEME, à raison de 20 réponses par jour, il ferait porter environ 5 gCO2e de fabrication à chaque réponse. C'est 36 fois le CO2e de l'électricité d'une réponse du modèle moyen d'un assistant, comptée avec la moyenne du monde, d'après notre calcul.
autant de CO2e que l'électricité de 1,3 million de réponses du modèle moyen d'un assistant, comptée avec l'électricité moyenne du monde (notre calcul).
Dans un centre de données, la fabrication des puces se partage entre des millions de demandes : la Base compte un serveur d'IA utilisé à 69 % de son temps pendant 5 ans. Google compte 0,01 gCO2e par question à Gemini pour ses émissions hors électricité, fabrication comprise.
Pour une organisation, le passage au calcul local déplace aussi les lignes du Bilan Carbone® : le service acheté sort des achats, l'électricité entre dans le poste Énergie et la machine dans les immobilisations. Notre analyse sur le compte de l'IA dans un Bilan Carbone® le détaille, y compris pour un serveur installé dans ses murs.
Le choix du modèle compte plus que le lieu du calcul
Pour nous, au Projet Celsius, une IA installée sur son ordinateur se justifie d'abord par d'autres raisons : garder ses textes chez soi, travailler sans connexion, ne dépendre d'aucun abonnement. Pour l'électricité, elle aide à 2 conditions : un modèle plus petit que celui du service qu'elle remplace, et une machine déjà achetée. Servi en ligne à de nombreux utilisateurs, un petit modèle dépenserait probablement moins encore, d'après l'estimation de la Base. Le choix du modèle et du mode de raisonnement reste ce qui pèse le plus sur l'électricité d'un usage ; notre analyse sur les gestes le chiffre sur une année.
Les valeurs du centre de données sont des estimations de la Base Impact de l'IA, calées sur la seule mesure en production publiée par un éditeur à notre connaissance (Google). Celles de l'ordinateur portable sont des mesures sur une machine à carte graphique de 2019, processeur et carte graphique seuls, ramenées à une réponse de 400 tokens par notre calcul ; une machine récente dépense moins. Le partage des puces est mesuré par une étude de Stanford sur une seule carte de centre de données, avec des questions dont la longueur n'est pas publiée ; son rapport entre la puce d'un Mac et celle d'un centre de données n'est pas retenu, la puissance du Mac qu'elle publie dépassant le maximum donné par Apple pour la machine entière. Les rapports en CO2e et la part de fabrication par réponse sont notre calcul.
Sources
10 documents
- Saad-Falcon, Narayan et al. (Stanford University et Together AI), Intelligence per Watt: Measuring Intelligence Efficiency of Local AI, prépublication arXiv, version 7 d'octobre 20262026fiche 242
- Husom, Goknil, Shar et Sen, The Price of Prompting: Profiling Energy Use in Large Language Models Inference, prépublication arXiv, version 2 de mars 20262026fiche 243
- Elsworth et al. (Google), Measuring the environmental impact of delivering AI at Google scale2025fiche 14
- Projet Celsius, Base Impact de l'IA, base de données environnementales de l'intelligence artificielle, moteur 0.3.12026fiche 144
- Apple, Mac Studio power consumption and thermal output (BTU) information, consulté en novembre 20262026fiche 246
- Aslan, Mayers, Koomey et France, Electricity Intensity of Internet Data Transmission: Untangling the Estimates, Journal of Industrial Ecology2018fiche 244
- Apple, Apple Intelligence Foundation Language Models Tech Report 20252025fiche 245
- Barros et al., Small is Sufficient: Reducing the World AI Energy Consumption Through Model Selection2025fiche 29
- Our World in Data, d'après Ember, Lifecycle carbon intensity of electricity2026fiche 34
- ADEME, Impact CO22026fiche 39
Chaque chiffre a été lu dans sa source ; la méthode du hub est décrite dans Méthode et sources.
Impact de l'IA, Projet Celsius, « Une IA installée sur son ordinateur consomme-t-elle moins ? », 13 novembre 2026. https://projetcelsius.com/ia/analyses/une-ia-installee-sur-son-ordinateur-consomme-t-elle-moins/
 Usages
 Eau















