
 Usages13 novembre 2026
Pourquoi le mode raisonnement et les agents consomment-ils beaucoup plus ?
Le texte qu'un modèle écrit et relit, et son énergie, en réponse directe, en raisonnement et en agent




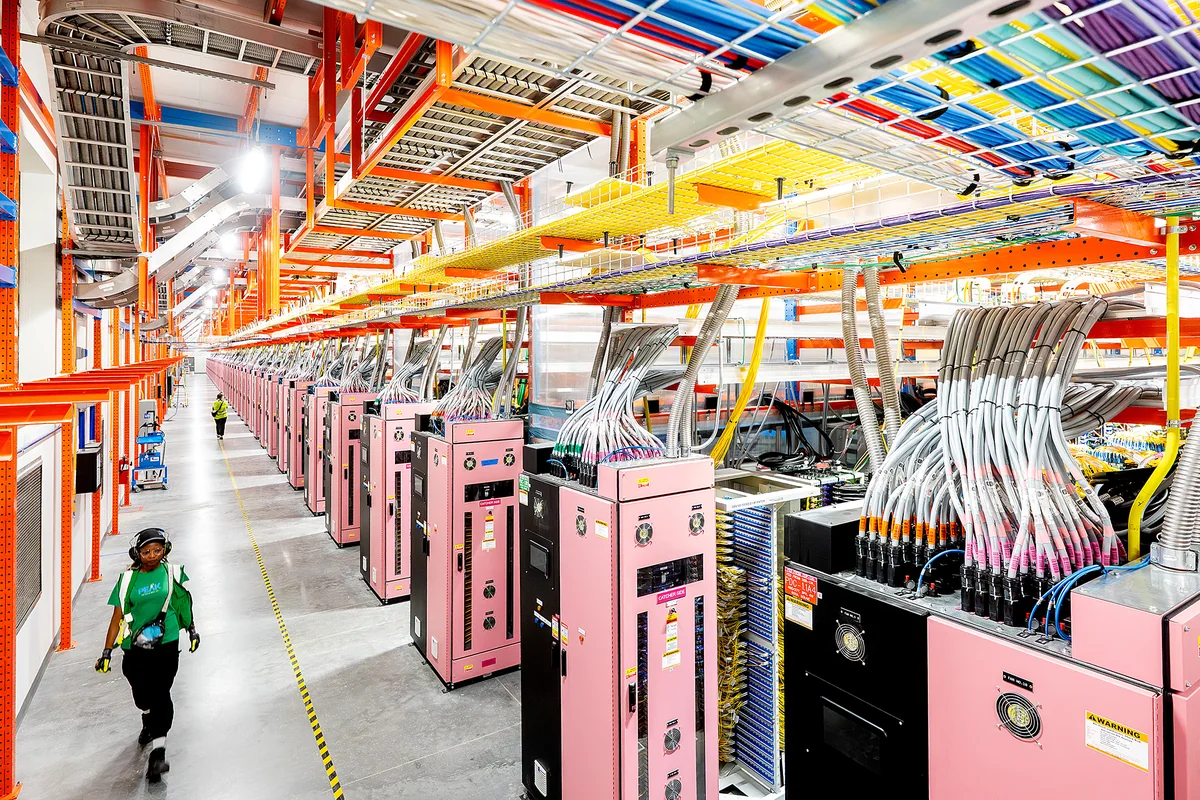
Une salle de Project Rainier, où AWS entraîne et sert les modèles Claude d'Anthropic. Photo Amazon (AWS), aboutamazon.com.
Un modèle de langage écrit sa réponse fragment par fragment, et chaque fragment, ou token, demande un passage dans tout le modèle ; à chaque appel, il relit aussi tout le texte qu'on lui donne. Son énergie suit donc la longueur du texte écrit et relu. En mode raisonnement, le modèle écrit d'abord un brouillon que l'utilisateur ne voit pas : l'énergie augmente de 92 % en moyenne sur les modèles ouverts mesurés par le PEReN, et de 150 à 700 fois pour les 3 modèles que Hugging Face a mesurés avec et sans raisonnement, selon la longueur du brouillon. Un agent enchaîne les appels et relit chaque fois son contexte : sur son propre usage de Claude Code, qu'il dit plus intensif que la moyenne, le climatologue Zeke Hausfather estime une instruction à environ 150 Wh, environ 600 fois l'énergie d'une question médiane à un assistant (250 à 1 200 fois).
Sommaire
Les chiffres les plus cités sur l'énergie de l'IA portent sur une requête courte à un assistant, de l'ordre de 0,3 Wh. Fin 2025, les modèles de raisonnement traitaient pourtant plus de la moitié des tokens passés par la plateforme OpenRouter, qui sert surtout des développeurs, et les agents enchaînent seuls les appels au modèle. Cette explication suit le texte que le modèle écrit et relit dans chaque mode, parce que l'énergie en dépend ; l'analyse sur l'évolution dans le temps suit la progression de ces usages.
Le token, unité de calcul
Un modèle de langage découpe le texte en tokens, des fragments de mot. Il écrit sa réponse un token après l'autre, et chaque token écrit demande un passage dans l'ensemble du modèle, sur des cartes graphiques (l'explication sur les cartes graphiques dit pourquoi). Avant d'écrire, il lit tout le texte qu'on lui donne : la question, la conversation précédente, les documents joints. L'énergie a donc 2 parts, l'une qui suit la longueur du texte écrit, l'autre celle du texte lu.
Epoch AI estime à 0,3 Wh une requête à GPT-4o qui écrit 500 tokens, et Microsoft estime à 0,31 Wh l'énergie d'une requête médiane dans un déploiement optimisé. Le texte lu pèse peu tant qu'il reste court. Avec 10 000 tokens en entrée, environ 20 pages, l'estimation d'Epoch AI passe à 2,4 Wh ; avec 100 000 tokens, à 40 Wh, parce que le calcul de la lecture croît plus vite que la longueur du texte quand celui-ci devient long.
Le mode raisonnement
En mode raisonnement, le modèle écrit d'abord un texte intermédiaire, où il décompose la question et vérifie ses étapes, puis sa réponse. L'utilisateur n'en voit le plus souvent qu'un résumé, ou rien, mais chaque token de ce brouillon coûte comme un token de la réponse. Hugging Face a mesuré 3 modèles ouverts avec et sans raisonnement : ils écrivent 300 à 800 fois plus de tokens et consomment 154 à 697 fois plus d'énergie avec le raisonnement activé, selon le modèle. En moyenne, les modèles de raisonnement de son classement consomment 30 fois plus que les modèles sans raisonnement, une comparaison entre familles de modèles plutôt qu'entre 2 réglages.
L'écart dépend de la longueur du brouillon, donc de la tâche et du réglage. Le PEReN, pour l'Arcep, a mesuré 22 modèles ouverts : activer le raisonnement y ajoute 92 % d'énergie en moyenne, avec un intervalle à 95 % de -21 % à +348 %, et 849 % en moyenne sur des exercices de programmation, contre 41 % sur des questions de culture générale. Pour GPT-5, l'estimation de Jegham et ses coauteurs va de 2,33 Wh avec un effort de raisonnement minimal à 17,15 Wh avec un effort élevé, pour une question de longueur moyenne, soit 7 fois plus. Sur une tâche de texte simple, l'AIE compte environ 2 fois l'électricité d'un modèle de taille comparable.
 Usages
Le mode raisonnement multiplie l'énergie
Énergie avec raisonnement, rapportée à la même demande sans, en multiple · Mesures de 2025 et 2026
Source : Arcep et PEReN, 2026 ; Hugging Face, 2025 · projetcelsius.com/ia · CC BY 4.0
Les agents
Un agent reçoit un objectif plutôt qu'une question. Il appelle le modèle, qui décide d'une action : lire un fichier, lancer une recherche, exécuter du code. Le résultat est ajouté au contexte, et le modèle est rappelé avec l'ensemble, qui s'allonge à chaque étape. Le texte relu grossit ainsi d'appel en appel. Anthropic indique que ses agents consomment environ 4 fois plus de tokens qu'une conversation, et ses systèmes à plusieurs agents environ 15 fois plus . Sur des tâches de correction de logiciels, Bai et ses coauteurs comptent 1 000 fois plus de tokens pour un agent que pour un échange de code ou un raisonnement sur du code, surtout des tokens d'entrée, c'est-à-dire du contexte relu.
Le climatologue Zeke Hausfather a relevé son propre usage de Claude Code pendant 8 semaines de 2026 : 1 138 instructions tapées, plus de 14 000 appels au modèle et 3,2 milliards de tokens. 96 % de ces tokens sont des relectures du contexte, mises en cache, et le texte qu'il voit ne fait que 0,4 % du total. Cela fait, selon lui, 12 appels et 2,9 millions de tokens en moyenne par instruction. Il en estime l'énergie à 150 Wh par instruction, de 60 à 290 Wh selon la méthode de conversion des tokens en énergie et le coût prêté à une relecture en cache (10 % de celui d'une lecture nouvelle dans son estimation centrale, de 1 à 25 % dans ses bornes) ; c'est l'estimation d'un utilisateur intensif, pas une étude. Microsoft estime que les requêtes longues de raisonnement et les requêtes d'agents consomment plus de 10 fois l'énergie d'une requête médiane, et l'AIE écrit que le raisonnement, les agents et la génération de vidéo peuvent consommer des centaines ou des milliers de fois l'énergie d'une génération de texte simple, sans détailler le calcul. D'autres estimations publiées, plus basses, sont détaillées dans notre article sur l'empreinte de Claude.
Les 3 modes comparés, d'après 3 sources
| Mode | Texte écrit et relu | Énergie estimée | Source |
|---|---|---|---|
| Réponse directe | environ 500 tokens écrits | 0,3 Wh | Epoch AI, GPT-4o, 2025 |
| Raisonnement | 300 à 800 fois les tokens du même modèle sans raisonnement | 2,33 Wh (effort minimal) à 17,15 Wh (effort élevé), question moyenne | Hugging Face, 2025 ; Jegham et al., GPT-5, 2025 |
| Agent de programmation | environ 2,9 millions de tokens par instruction, en 12 appels environ, dont 96 % relus en cache | 150 Wh (60 à 290) | Zeke Hausfather, Claude Code, 2026 |
Estimations de sources différentes, sur des modèles différents : des ordres de grandeur, pas la mesure d'un même modèle dans 3 modes. Tokens et appels par instruction : moyennes données par Zeke Hausfather.
D'une réponse courte estimée à 0,3 Wh à une instruction d'agent estimée à 150 Wh, le rapport est de 500 environ, notre calcul ; Zeke Hausfather compte, lui, environ 600 fois une question médiane. Une instruction d'agent n'est pas une question : elle déclenche en moyenne 12 appels au modèle. L'écart tient d'abord au nombre de tokens : un brouillon plus long, puis un contexte relu à chaque appel. À l'échelle d'une journée, l'usage intensif d'agents relevé par Zeke Hausfather fait environ 3 kWh ; l'analyse d'une année d'usage en tire l'ordre de grandeur annuel, l'analyse des tâches par métier le replace à côté des autres usages, et celle sur les gestes chiffre ce que change le choix du mode.
Notre lecture
Pour nous, au Projet Celsius, un chiffre d'énergie « par requête » ne dit plus grand-chose s'il ne précise pas le mode. La réponse courte, autour de 0,3 Wh, est l'usage le mieux documenté et le moins coûteux ; le raisonnement et les agents la multiplient de 2 à plusieurs centaines de fois selon le modèle, la tâche et les estimations disponibles, et ce sont eux qui se répandent. Les éditeurs ne publient pas l'énergie de leurs modes de raisonnement ni de leurs agents : les ordres de grandeur ci-dessus viennent de modèles ouverts, d'estimations extérieures et du relevé d'un utilisateur. Pour l'utilisateur, le levier est le même dans les 2 cas : la quantité de texte que l'on fait écrire et relire au modèle.
Les énergies citées sont des estimations, sauf les mesures de Hugging Face et du PEReN, faites sur des modèles ouverts et sur la carte graphique seule. Les 3 modes du tableau viennent de sources et de modèles différents : l'écart entre eux est un ordre de grandeur. L'estimation de Zeke Hausfather porte sur son seul usage et dépend de la méthode de conversion et du coût prêté aux relectures en cache. D'autres estimations de l'énergie d'un agent, faites sur d'autres usages, donnent des valeurs plus basses.
Sources
11 documents
- OpenRouter et a16z, State of AI2025fiche 466
- Epoch AI, How much energy does ChatGPT use?2025fiche 20
- Oviedo, Kazhamiaka, Choukse et al. (Microsoft), Energy use of AI inference, efficiency pathways, and test-time scaling, Joule2026fiche 198
- Hugging Face, AI Energy Score v22025fiche 26
- PEReN pour l'Arcep, Étude IA et environnement, rapport technique2025fiche 121
- Jegham, Abdelatti, Elmoubarki et Hendawi, How Hungry is AI? Benchmarking Energy, Water, and Carbon Footprint of LLM Inference, version 62025fiche 239
- AIE, Energy and AI2025fiche 1
- Anthropic, How we built our multi-agent research system, 13 juin 20252025fiche 328
- Bai et al., How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks, arXiv 2604.227502026fiche 465
- Zeke Hausfather, The real energy use of agentic AI, The Climate Brink2026fiche 120
- AIE, Key Questions on Energy and AI2026fiche 2
Chaque chiffre a été lu dans sa source ; la méthode du hub est décrite dans Méthode et sources.
Impact de l'IA, Projet Celsius, « Pourquoi le mode raisonnement et les agents consomment-ils beaucoup plus ? », 13 novembre 2026. https://projetcelsius.com/ia/analyses/pourquoi-le-mode-raisonnement-et-les-agents-consomment-ils-plus/



 Électricité